24.1.22. التحليل المتجهي
24.1.22.1. إحصاءات أساسية للحقول
تولّد إحصاءات أساسية لحقل من جدول البيانات الوصفية لطبقة متجهية. الحقول الرقمية وحقول التاريخ والوقت والنصوص مدعومة. تعتمد الإحصاءات المُعادة على نوع الحقل.
يمكن توليد الإحصاءات كجدول أو كملف HTML، وهي متاحة في .
القائمة الافتراضية:
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الطبقة المتجهية المُدخلة |
|
[vector: any] |
الطبقة المتجهية المراد حساب الإحصاءات عليها |
الحقل المراد حساب الإحصاءات عليه |
|
[tablefield: any] |
أي حقل جدول مدعوم لحساب الإحصاءات |
الإحصاءات اختياري
|
|
[vector: table] الافتراضي: |
حدّد جدول المخرجات للإحصاءات المولّدة. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
تقرير الإحصاءات اختياري |
|
[html] الافتراضي: |
تحديد ملف الإحصاءات المحسوبة. أحد الخيارات التالية:
|
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الإحصاءات
|
|
[vector: table] |
جدول يحتوي على الإحصاءات المحسوبة |
تقرير الإحصاءات |
|
[html] |
ملف HTML يحتوي على الإحصاءات المحسوبة |
العدد |
|
[numeric: integer] |
|
عدد القيم الفريدة |
|
[numeric: integer] |
|
عدد القيم الفارغة (null) |
|
[numeric: integer] |
|
عدد القيم غير الفارغة |
|
[numeric: integer] |
|
القيمة الدنيا |
|
[same as input] |
|
القيمة العظمى |
|
[same as input] |
|
أدنى طول |
|
[numeric: integer] |
|
أقصى طول |
|
[numeric: integer] |
|
متوسط الطول |
|
[numeric: double] |
|
معامل الاختلاف |
|
[numeric: double] |
|
المجموع |
|
[numeric: double] |
|
القيمة المتوسطة |
|
[numeric: double] |
|
الانحراف المعياري |
|
[numeric: double] |
|
المدى |
|
[numeric: double] |
|
الوسيط |
|
[numeric: double] |
|
الأقلية (القيمة الأندر تكرارًا) |
|
[same as input] |
|
الأغلبية (القيمة الأكثر تكرارًا) |
|
[same as input] |
|
الربيع الأول |
|
[numeric: double] |
|
الربيع الثالث |
|
[numeric: double] |
|
المدى الربيعي (IQR) |
|
[numeric: double] |
شيفرة Python
معرّف الخوارزمية: native:basicstatisticsforfields
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.2. الصعود على طول الخط
تحسب إجمالي الصعود والهبوط على طول الأشكال الهندسية الخطية. يجب أن تحتوي الطبقة المُدخلة على قيم Z. إذا لم تكن قيم Z متاحة، يمكن استخدام خوارزمية Drape (set Z value from raster) (الإسقاط على السطح - ضبط قيمة Z من طبقة شبكية) لإضافة قيم Z من طبقة نموذج ارتفاع رقمي.
الطبقة الناتجة نسخة من الطبقة المُدخلة مع حقول إضافية تحتوي على إجمالي الصعود (climb) وإجمالي الهبوط (descent) وأدنى ارتفاع (minelev) وأقصى ارتفاع (maxelev) لكل شكل هندسي خطي. إذا احتوت الطبقة المُدخلة على حقول بالأسماء نفسها لهذه الحقول المضافة، فستُعاد تسميتها (تُغيَّر أسماء الحقول إلى "name_2" و "name_3" وهكذا، باختيار أول اسم غير مكرر).
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الطبقة الخطية |
|
[vector: line] |
الطبقة الخطية المراد حساب الصعود لها. يجب أن تحتوي على قيم Z |
طبقة الصعود |
|
[vector: line] الافتراضي: |
تحديد الطبقة الناتجة (الخطية). أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
طبقة الصعود |
|
[vector: line] |
طبقة خطية تحتوي على سمات جديدة بنتائج حسابات الصعود. |
إجمالي الصعود |
|
[numeric: double] |
مجموع الصعود لجميع الأشكال الهندسية الخطية في الطبقة المُدخلة |
إجمالي الهبوط |
|
[numeric: double] |
مجموع الهبوط لجميع الأشكال الهندسية الخطية في الطبقة المُدخلة |
أدنى ارتفاع |
|
[numeric: double] |
أدنى ارتفاع للأشكال الهندسية في الطبقة |
أقصى ارتفاع |
|
[numeric: double] |
أقصى ارتفاع للأشكال الهندسية في الطبقة |
شيفرة Python
معرّف الخوارزمية: native:climbalongline
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.3. عدّ النقاط داخل المضلع
تأخذ طبقة نقاط وطبقة مضلعات وتعدّ النقاط من طبقة النقاط الواقعة في كل مضلع من مضلعات طبقة المضلعات.
تُولَّد طبقة مضلعات جديدة بالمحتوى نفسه تمامًا للطبقة المضلعة المُدخلة، لكنها تحتوي على حقل إضافي بعدد النقاط المقابل لكل مضلع.
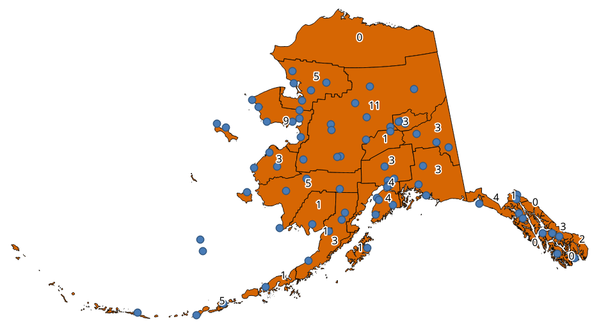
شكل 24.81 تُظهر التسميات في المضلعات عدد النقاط
يمكن استخدام حقل وزن اختياري لإسناد أوزان لكل نقطة. وبدلًا من ذلك، يمكن تحديد حقل فئات فريدة. إذا استُخدم الخياران معًا، فستكون الأولوية لحقل الوزن وسيُتجاهل حقل الفئات الفريدة.
 تتيح تعديل المعالم في مكانها لمعالم المضلعات
Default menu:
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
المضلعات |
|
[vector: polygon] |
طبقة مضلعات ترتبط معالمها بعدد النقاط التي تحتويها |
النقاط |
|
[vector: point] |
طبقة نقاط تحتوي على المعالم المراد عدّها |
حقل الوزن اختياري |
|
[tablefield: any] |
حقل من طبقة النقاط. سيكون العدد المولّد مجموع قيم حقل الوزن للنقاط الواقعة داخل المضلع. إذا لم يكن حقل الوزن رقميًا، فسيكون العدد |
حقل الفئة اختياري |
|
[tablefield: any] |
تُصنَّف النقاط بناءً على السمة المحددة، وإذا وقعت عدة نقاط لها قيمة السمة نفسها داخل المضلع، فلا تُعدّ إلا واحدة منها. وبالتالي فإن العدد النهائي للنقاط في المضلع هو عدد الفئات المختلفة الموجودة فيه. |
اسم حقل العدد |
|
[string] الافتراضي: 'NUMPOINTS' |
اسم الحقل الذي يُخزَّن فيه عدد النقاط |
العدد |
|
[vector: polygon] الافتراضي: |
تحديد الطبقة الناتجة. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
العدد |
|
[vector: polygon] |
الطبقة الناتجة مع جدول بيانات وصفية يحتوي على العمود الجديد بعدد النقاط |
شيفرة Python
معرّف الخوارزمية: native:countpointsinpolygon
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.4. التجميع العنقودي DBSCAN
تجمّع معالم النقاط في عناقيد بناءً على تطبيق ثنائي الأبعاد لخوارزمية التجميع المكاني القائم على الكثافة للتطبيقات ذات الضوضاء (DBSCAN).
تتطلب الخوارزمية معاملين: الحد الأدنى لحجم العنقود، والمسافة القصوى المسموح بها بين النقاط المجمّعة.
المعاملات
المعاملات الأساسية
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الطبقة المُدخلة |
|
[vector: point] |
الطبقة المراد تحليلها |
الحد الأدنى لحجم العنقود |
|
[numeric: integer] الافتراضي: 5 |
الحد الأدنى لعدد المعالم اللازم لتكوين عنقود |
المسافة القصوى بين النقاط المجمّعة |
|
[numeric: double] الافتراضي: 1.0 |
المسافة التي لا يمكن بعدها أن ينتمي معلمان إلى العنقود نفسه (eps) |
العناقيد |
|
[vector: point] الافتراضي: |
حدّد الطبقة المتجهية لنتيجة التجميع العنقودي. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المعاملات المتقدمة
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
معاملة النقاط الحدّية كضوضاء (DBSCAN*) |
|
[boolean] الافتراضي: False |
إذا فُعّل هذا الخيار، تُعامَل النقاط الواقعة على حدود العنقود كنقاط غير مجمّعة، ولا توسَم كنقاط مجمّعة إلا النقاط الواقعة داخل العنقود. |
اسم حقل العنقود |
|
[string] الافتراضي: 'CLUSTER_ID' |
اسم الحقل الذي سيُخزَّن فيه رقم العنقود المرتبط |
اسم حقل حجم العنقود |
|
[string] الافتراضي: 'CLUSTER_SIZE' |
اسم الحقل الذي يحتوي على عدد المعالم في العنقود نفسه |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
العناقيد |
|
[vector: point] |
طبقة متجهية تحتوي على المعالم الأصلية مع حقل يحدد العنقود الذي تنتمي إليه |
عدد العناقيد |
|
[numeric: integer] |
عدد العناقيد المكتشفة |
شيفرة Python
معرّف الخوارزمية: native:dbscanclustering
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.5. مصفوفة المسافات
تحسب لمعالم النقاط المسافات إلى أقرب المعالم إليها في الطبقة نفسها أو في طبقة أخرى.
القائمة الافتراضية:
شاهد أيضا
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
طبقة النقاط المُدخلة |
|
[vector: point] |
طبقة النقاط التي تُحسب لها مصفوفة المسافات (نقاط المنشأ) |
حقل المعرّف الفريد للمُدخل |
|
[tablefield: any] |
الحقل المستخدم لتعريف معالم الطبقة المُدخلة تعريفًا فريدًا. يُستخدم في جدول البيانات الوصفية الناتج. |
طبقة النقاط الهدف |
|
[vector: point] |
طبقة النقاط التي تحتوي على أقرب نقطة (أو نقاط) يُبحث عنها (نقاط الوجهة) |
حقل المعرّف الفريد للهدف |
|
[tablefield: any] |
الحقل المستخدم لتعريف معالم الطبقة الهدف تعريفًا فريدًا. يُستخدم في جدول البيانات الوصفية الناتج. |
نوع المصفوفة الناتجة |
|
[enumeration] الافتراضي: 0 |
تتوفر أنواع مختلفة من الحساب:
|
استخدام أقرب (k) نقاط هدف فقط |
|
[numeric: integer] الافتراضي: 0 |
يمكنك اختيار حساب المسافة إلى جميع النقاط في الطبقة الهدف (0) أو الاقتصار على عدد (k) من أقرب المعالم. |
مصفوفة المسافات |
|
[vector: point] الافتراضي: |
تحديد الطبقة المتجهية الناتجة. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
مصفوفة المسافات |
|
[vector: point] |
طبقة متجهية نقطية (أو MultiPoint في حالة "Linear (N * k x 3)") تحتوي على حساب المسافة لكل معلم مُدخل. تعتمد معالمها وجدول بياناتها الوصفية على نوع المصفوفة الناتجة المختار. |
شيفرة Python
معرّف الخوارزمية: qgis:distancematrix
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.6. المسافة إلى أقرب مركز (خط إلى المركز)
تُنشئ خطوطًا تصل كل معلم من طبقة متجهية مُدخلة بأقرب معلم في طبقة الوجهة. تُحسب المسافات بناءً على مركز كل معلم.
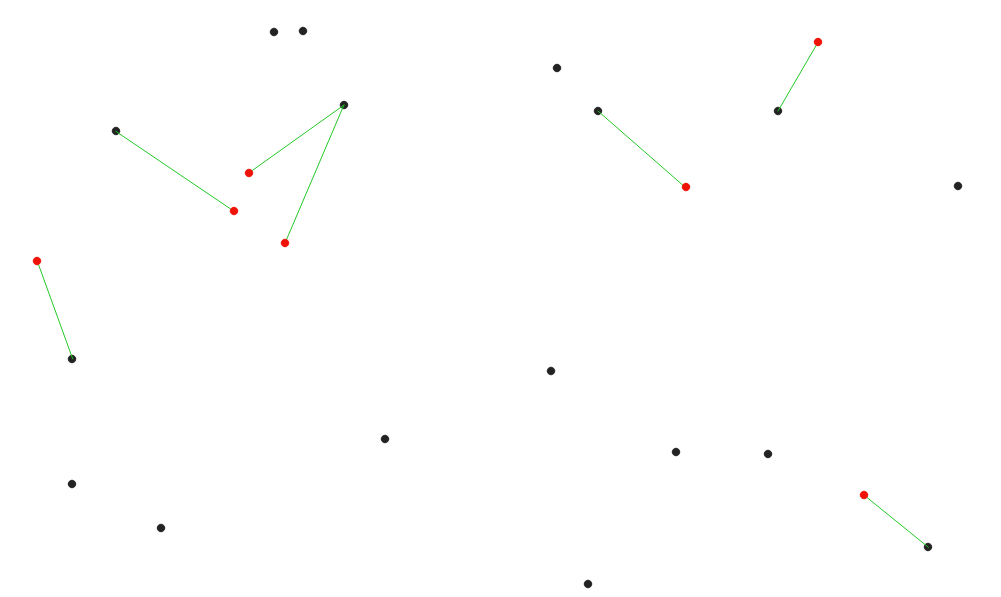
شكل 24.82 عرض أقرب مركز للمعالم المُدخلة الحمراء
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
طبقة نقاط المصدر |
|
[vector: geometry] |
الطبقة المتجهية التي يُبحث عن أقرب معلم لمعالمها |
طبقة المراكز الوجهة |
|
[vector: geometry] |
طبقة متجهية تحتوي على المعالم المراد البحث عنها |
سمة اسم طبقة المراكز |
|
[tablefield: any] |
الحقل المستخدم لتعريف معالم طبقة الوجهة تعريفًا فريدًا. يُستخدم في جدول البيانات الوصفية الناتج |
وحدة القياس |
|
[enumeration] الافتراضي: 0 |
الوحدات التي تُعطى بها المسافة إلى أقرب معلم:
|
المسافة إلى المركز |
|
[vector: line] الافتراضي: |
حدّد الطبقة المتجهية الخطية الناتجة التي تصل بين النقاط المتطابقة. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
المسافة إلى المركز |
|
[vector: line] |
طبقة متجهية خطية تحتوي على سمات المعالم المُدخلة ومعرّف أقرب معلم إليها والمسافة المحسوبة. |
شيفرة Python
معرّف الخوارزمية: qgis:distancetonearesthublinetohub
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.7. المسافة إلى أقرب مركز (نقاط)
تُنشئ طبقة نقاط تمثّل مركز المعالم المُدخلة مع إضافة حقلين يحتويان على معرّف أقرب معلم (بناءً على نقطة مركزه) والمسافة بين النقاط.
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
طبقة نقاط المصدر |
|
[vector: any] |
الطبقة المتجهية التي يُبحث عن أقرب معلم لمعالمها |
طبقة المراكز الوجهة |
|
[vector: any] |
طبقة متجهية تحتوي على المعالم المراد البحث عنها |
سمة اسم طبقة المراكز |
|
[tablefield: any] |
الحقل المستخدم لتعريف معالم طبقة الوجهة تعريفًا فريدًا. يُستخدم في جدول البيانات الوصفية الناتج |
وحدة القياس |
|
[enumeration] الافتراضي: 0 |
الوحدات التي تُعطى بها المسافة إلى أقرب معلم:
|
المسافة إلى المركز |
|
[vector: point] الافتراضي: |
حدّد الطبقة المتجهية النقطية الناتجة التي تحتوي على أقرب مركز. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
المسافة إلى المركز |
|
[vector: point] |
طبقة متجهية نقطية تمثّل مركز معالم المصدر مع سماتها ومعرّف أقرب معلم إليها والمسافة المحسوبة. |
شيفرة Python
معرّف الخوارزمية: qgis:distancetonearesthubpoints
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.8. الربط بالخطوط (خطوط المراكز)
تُنشئ مخططات المركز والأذرع (hub and spoke) بتوصيل خطوط من النقاط في طبقة الأذرع (Spoke) إلى النقاط المطابقة في طبقة المراكز (Hub).
يُحدَّد المركز المرتبط بكل نقطة بناءً على التطابق بين حقل Hub ID في نقاط المراكز وحقل Spoke ID في نقاط الأذرع.
إذا لم تكن الطبقات المُدخلة طبقات نقاط، فستُؤخذ نقطة على سطح الأشكال الهندسية كموقع للتوصيل.
يمكن اختياريًا إنشاء خطوط جيوديسية تمثّل أقصر مسار على سطح الإهليلج (ellipsoid). عند استخدام الوضع الجيوديسي، يمكن تقسيم الخطوط المُنشأة عند خط الزوال المقابل (خط طول ±180 درجة)، مما قد يحسّن رسم الخطوط. كما يمكن تحديد المسافة بين الرؤوس؛ فكلما صغرت المسافة نتج خط أكثف وأدق.
تحذير
تحذف هذه الخوارزمية المفاتيح الأساسية أو قيم FID الموجودة وتعيد توليدها في الطبقات الناتجة.
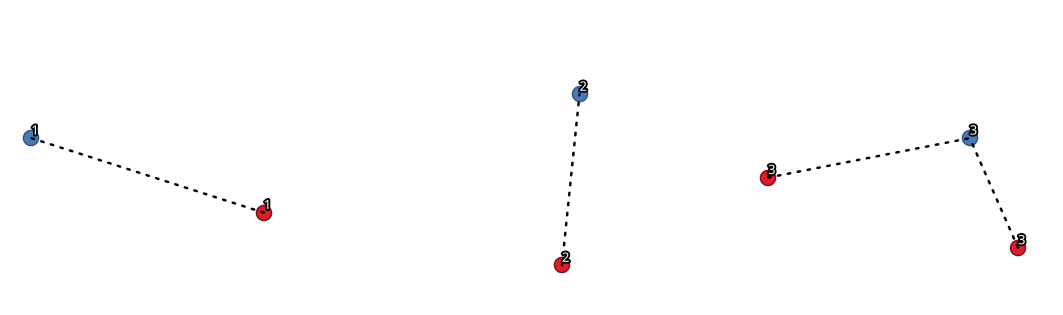
شكل 24.83 ربط النقاط بناءً على حقل / سمة مشتركة
المعاملات
المعاملات الأساسية
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
طبقة المراكز |
|
[vector: geometry] |
الطبقة المُدخلة |
حقل معرّف المركز |
|
[tablefield: any] |
حقل طبقة المراكز الذي يحتوي على المعرّف المراد الربط به |
حقول طبقة المراكز المراد نسخها (اتركها فارغة لنسخ جميع الحقول) اختياري |
|
[tablefield: any] [list] |
حقل (أو حقول) طبقة المراكز المراد نسخها. إذا لم يُختر أي حقل، تُؤخذ جميع الحقول. |
طبقة الأذرع |
|
[vector: geometry] |
طبقة نقاط الأذرع الإضافية |
حقل معرّف الذراع |
|
[tablefield: any] |
حقل طبقة الأذرع الذي يحتوي على المعرّف المراد الربط به |
حقول طبقة الأذرع المراد نسخها (اتركها فارغة لنسخ جميع الحقول) اختياري |
|
[tablefield: any] [list] |
حقل (أو حقول) طبقة الأذرع المراد نسخها. إذا لم يُختر أي حقل، تُؤخذ جميع الحقول. |
إنشاء خطوط جيوديسية |
|
[boolean] الافتراضي: False |
إنشاء خطوط جيوديسية (أقصر مسار على سطح الإهليلج) |
خطوط المراكز |
|
[vector: line] الافتراضي: |
حدّد الطبقة المتجهية الناتجة لخطوط المراكز. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المعاملات المتقدمة
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
المسافة بين الرؤوس (للخطوط الجيوديسية فقط) |
|
[numeric: double] الافتراضي: 1000.0 (كيلومتر) |
المسافة بين الرؤوس المتتالية (بالكيلومتر). كلما صغرت المسافة نتج خط أكثف وأدق |
تقسيم الخطوط عند خط الزوال المقابل (خط طول ±180 درجة) |
|
[boolean] الافتراضي: False |
تقسيم الخطوط عند خط طول ±180 درجة (لتحسين رسم الخطوط) |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
خطوط المراكز |
|
[vector: line] |
الطبقة الخطية الناتجة التي تصل بين النقاط المتطابقة في الطبقات المُدخلة |
شيفرة Python
معرّف الخوارزمية: native:hublines
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.9. التجميع العنقودي K-means
تحسب رقم عنقود K-means القائم على المسافة ثنائية الأبعاد لكل معلم مُدخل.
يهدف التجميع العنقودي K-means إلى تقسيم المعالم إلى k عنقودًا بحيث ينتمي كل معلم إلى العنقود ذي المتوسط الأقرب. وتُمثَّل النقطة المتوسطة بمركز ثقل المعالم المجمّعة.
إذا كانت الأشكال الهندسية المُدخلة خطوطًا أو مضلعات، فيعتمد التجميع على مركز المعلم (centroid).
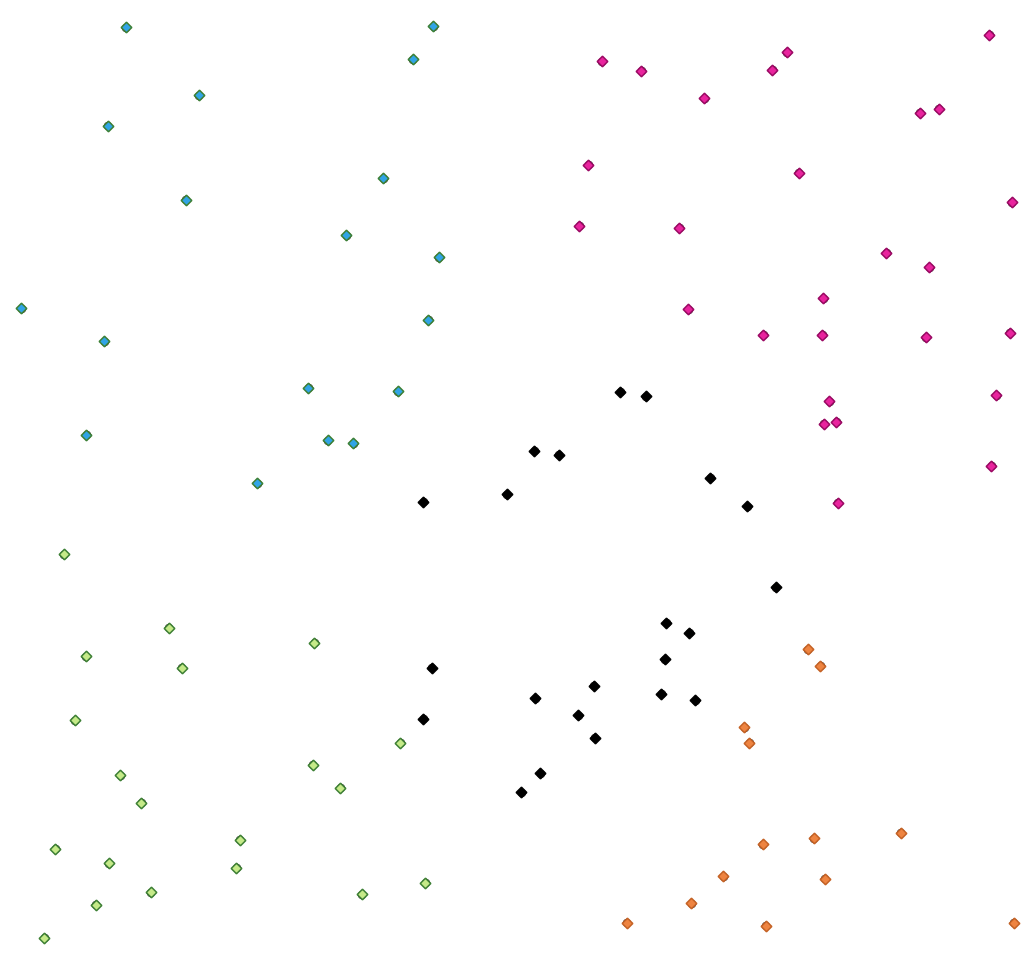
شكل 24.84 عناقيد نقاط من خمس فئات
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الطبقة المُدخلة |
|
[vector: geometry] |
الطبقة المراد تحليلها |
عدد العناقيد |
|
[numeric: integer] الافتراضي: 5 |
عدد العناقيد المراد إنشاؤها من المعالم |
الطريقة |
|
[enumeration] الافتراضي: 0 |
طريقة اختيار المراكز الأولية. القيم الممكنة هي:
المراجع: Arthur, David & Vassilvitskii, Sergei. (2007). K-Means++: The Advantages of Careful Seeding. Proc. of the Annu. ACM-SIAM Symp. on Discrete Algorithms. 8. |
العناقيد |
|
[vector: same as input] الافتراضي: |
حدّد الطبقة المتجهية الناتجة للعناقيد المولّدة. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المعاملات المتقدمة
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
اسم حقل العنقود |
|
[string] الافتراضي: 'CLUSTER_ID' |
اسم الحقل الذي سيُخزَّن فيه رقم العنقود المرتبط |
اسم حقل حجم العنقود |
|
[string] الافتراضي: 'CLUSTER_SIZE' |
اسم الحقل الذي يحتوي على عدد المعالم في العنقود نفسه |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
العناقيد |
|
[vector: same as input] |
طبقة متجهية تحتوي على المعالم الأصلية مع حقول تحدد العنقود الذي تنتمي إليه وعددها فيه |
شيفرة Python
معرّف الخوارزمية: native:kmeansclustering
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.10. سرد القيم الفريدة
تسرد القيم الفريدة لحقل في جدول البيانات الوصفية وتعدّها.
القائمة الافتراضية:
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الطبقة المُدخلة |
|
[vector: any] |
الطبقة المراد تحليلها |
الحقل (أو الحقول) الهدف |
|
[tablefield: any] [list] |
الحقل (أو الحقول) المراد تحليلها |
القيم الفريدة اختياري |
|
[vector: table] الافتراضي: |
حدّد طبقة الجدول الملخّص للقيم الفريدة. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
تقرير HTML اختياري |
|
[html] الافتراضي: |
تقرير HTML بالقيم الفريدة في . أحد الخيارات التالية:
|
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
القيم الفريدة |
|
[vector: table] |
طبقة جدول ملخّص بالقيم الفريدة |
تقرير HTML |
|
[html] |
تقرير HTML بالقيم الفريدة. يمكن فتحه من |
إجمالي القيم الفريدة |
|
[numeric: integer] |
عدد القيم الفريدة في الحقل المُدخل |
القيم الفريدة مجمّعة |
|
[string] |
نص يحتوي على قائمة القيم الفريدة الموجودة في الحقل المُدخل مفصولة بفواصل |
شيفرة Python
معرّف الخوارزمية: native:listuniquevalues
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.11. متوسط الإحداثيات
تحسب طبقة نقاط تحتوي على مركز الكتلة للأشكال الهندسية في طبقة مُدخلة.
يمكن تحديد سمة تحتوي على أوزان تُطبَّق على كل معلم عند حساب مركز الكتلة.
إذا حُدِّدت سمة في المعامل، فستُجمَّع المعالم وفقًا لقيم هذا الحقل. وبدلًا من نقطة واحدة تمثّل مركز كتلة الطبقة كلها، ستحتوي الطبقة الناتجة على مركز كتلة لمعالم كل فئة.
القائمة الافتراضية:
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الطبقة المُدخلة |
|
[vector: geometry] |
الطبقة المتجهية المُدخلة |
حقل الوزن اختياري |
|
[tablefield: numeric] |
الحقل المستخدم إذا أردت حساب متوسط موزون |
حقل المعرّف الفريد |
|
[tablefield: any] |
الحقل الفريد الذي سيُحسب المتوسط على أساسه |
متوسط الإحداثيات |
|
[vector: point] الافتراضي: |
حدّد الطبقة (المتجهية النقطية) للنتيجة. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
متوسط الإحداثيات |
|
[vector: point] |
طبقة النقطة (أو النقاط) الناتجة |
شيفرة Python
معرّف الخوارزمية: native:meancoordinates
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.12. تحليل الجار الأقرب
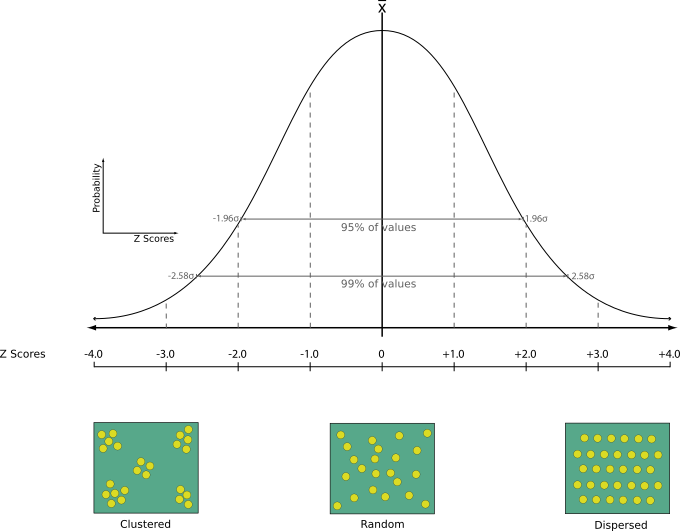
تُجري تحليل الجار الأقرب لطبقة نقاط. تخبرك النتيجة بكيفية توزّع بياناتك (متجمّعة، أو عشوائية، أو متباعدة).
تُولَّد النتيجة كملف HTML يحتوي على القيم الإحصائية المحسوبة:
متوسط المسافة المرصودة
متوسط المسافة المتوقعة
مؤشر الجار الأقرب
عدد النقاط
Z-Score: تخبرك مقارنة قيمة Z-Score بالتوزيع الطبيعي بكيفية توزّع بياناتك. تعني قيمة Z-Score المنخفضة أن البيانات يُرجَّح أن تكون نتيجة عملية عشوائية مكانيًا، بينما تعني قيمة Z-Score المرتفعة أن بياناتك. تعني قيمة Z-Score القريبة من 0 أن البيانات يُرجَّح أن تكون نتيجة عملية عشوائية مكانيًا، بينما تعني قيمة Z-Score البعيدة عن 0 أن البيانات يُستبعد أن تكون نتيجة عملية عشوائية مكانيًا.
القائمة الافتراضية:
شاهد أيضا
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الطبقة المُدخلة |
|
[vector: point] |
طبقة متجهية نقطية لحساب الإحصاءات عليها |
الجار الأقرب اختياري |
|
[html] الافتراضي: |
تحديد ملف HTML للإحصاءات المحسوبة. أحد الخيارات التالية:
|
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الجار الأقرب |
|
[html] |
ملف HTML يحتوي على الإحصاءات المحسوبة |
متوسط المسافة المرصودة |
|
[numeric: double] |
متوسط المسافة المرصودة |
متوسط المسافة المتوقعة |
|
[numeric: double] |
متوسط المسافة المتوقعة |
مؤشر الجار الأقرب |
|
[numeric: integer] |
مؤشر الجار الأقرب |
عدد النقاط |
|
[numeric: integer] |
عدد النقاط |
Z-Score |
|
[numeric: double] |
Z-Score |
شيفرة Python
معرّف الخوارزمية: native:nearestneighbouranalysis
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.13. تحليل التداخل
تحسب المساحة ونسبة التغطية التي تتداخل بها معالم الطبقات المتراكبة المختارة مع معالم الطبقة المُدخلة.
تُضاف إلى الطبقة الناتجة سمات جديدة تُبيّن إجمالي مساحة التداخل والنسبة المئوية للمعلم المُدخل التي تتداخل معها كل طبقة من الطبقات المتراكبة المختارة.
ملاحظة
تستخدم هذه الخوارزمية قياسات مبنية على الإهليلج وتحترم إعدادات الإهليلج الحالية.
المعاملات
المعاملات الأساسية
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الطبقة المُدخلة |
|
[vector: polygon] |
الطبقة المُدخلة. |
الطبقات المتراكبة |
|
[vector: polygon] [list] |
الطبقات المتراكبة. |
التداخل |
|
[same as input] الافتراضي: |
حدّد الطبقة المتجهية الناتجة. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المعاملات المتقدمة
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
حجم الشبكة اختياري |
|
[numeric: double] الافتراضي: غير محدد |
إذا حُدِّد، تُلتقط الأشكال الهندسية المُدخلة إلى شبكة بالحجم المعطى، وتُحسب رؤوس النتيجة على الشبكة نفسها. |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
التداخل |
|
[same as input] |
الطبقة الناتجة مع حقول إضافية تُبيّن التداخل (بوحدات الخريطة وبالنسبة المئوية) للمعلم المُدخل مع كل طبقة من الطبقات المختارة. |
شيفرة Python
معرّف الخوارزمية: native:calculatevectoroverlaps
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.14. أقصر خط بين المعالم
تُنشئ طبقة خطية تمثّل أقصر خط بين طبقة المصدر وطبقة الوجهة. افتراضيًا لا يُؤخذ في الحسبان إلا أقرب معلم أول من طبقة الوجهة. ويمكن تحديد عدد المعالم المجاورة الأقرب (n). وإذا حُدِّدت مسافة قصوى، فلن تُؤخذ في الحسبان إلا المعالم الأقرب من هذه المسافة.
ستحتوي المعالم الناتجة على جميع سمات طبقة المصدر، وجميع سمات المعالم الأقرب (n)، والحقل الإضافي للمسافة.
مهم
تستخدم هذه الخوارزمية حسابات ديكارتية بحتة للمسافة، ولا تأخذ في الحسبان الخصائص الجيوديسية أو الإهليلجية عند تحديد قرب المعالم. ويعتمد نظام القياس ونظام الإحداثيات الناتج على نظام إحداثيات طبقة المصدر.
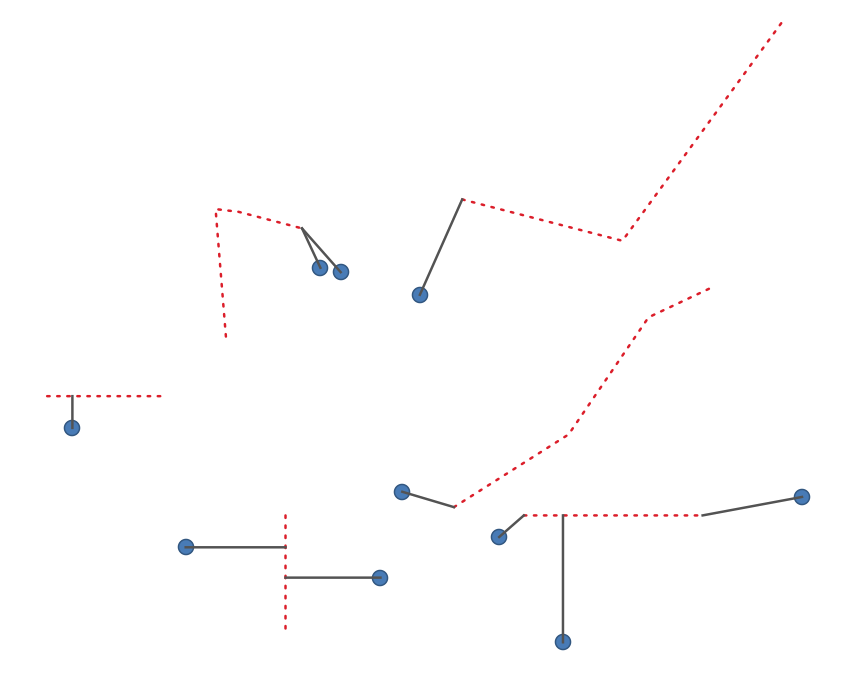
شكل 24.85 أقصر خط من معالم النقاط إلى الخطوط
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
طبقة المصدر |
|
[vector: geometry] |
طبقة المنشأ التي يُبحث لها عن أقرب الجيران |
طبقة الوجهة |
|
[vector: geometry] |
الطبقة الهدف التي يُبحث فيها عن أقرب الجيران |
الطريقة |
|
[enumeration] الافتراضي: 0 |
طريقة حساب أقصر مسافة. القيم الممكنة هي:
|
الحد الأقصى لعدد الجيران |
|
[numeric: integer] الافتراضي: 1 |
الحد الأقصى لعدد الجيران المراد البحث عنهم |
المسافة القصوى اختياري |
|
[numeric: double] |
لن تُؤخذ في الحسبان إلا معالم الوجهة الأقرب من هذه المسافة. |
أقصر الخطوط |
|
[vector: line] الافتراضي: |
حدّد الطبقة المتجهية الناتجة. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الطبقة الناتجة |
|
[vector: line] |
طبقة متجهية خطية تصل معالم المصدر بأقرب جار (أو جيران) لها في طبقة الوجهة. تحتوي على جميع سمات معالم المصدر والوجهة، والمسافة المحسوبة. |
شيفرة Python
معرّف الخوارزمية: native:shortestline
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.15. التجميع العنقودي ST-DBSCAN
تجمّع معالم النقاط في عناقيد بناءً على تطبيق ثنائي الأبعاد لخوارزمية التجميع الزماني المكاني القائم على الكثافة للتطبيقات ذات الضوضاء (ST-DBSCAN).
شاهد أيضا
المعاملات
المعاملات الأساسية
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الطبقة المُدخلة |
|
[vector: point] |
الطبقة المراد تحليلها |
حقل التاريخ/الوقت |
|
[tablefield: date] |
الحقل الذي يحتوي على المعلومات الزمنية |
الحد الأدنى لحجم العنقود |
|
[numeric: integer] الافتراضي: 5 |
الحد الأدنى لعدد المعالم اللازم لتكوين عنقود |
المسافة القصوى بين النقاط المجمّعة |
|
[numeric: double] الافتراضي: 1.0 |
المسافة التي لا يمكن بعدها أن ينتمي معلمان إلى العنقود نفسه (eps) |
المدة الزمنية القصوى بين النقاط المجمّعة |
|
[numeric: double] الافتراضي: 0.0 (أيام) |
المدة الزمنية التي لا يمكن بعدها أن ينتمي معلمان إلى العنقود نفسه (eps2). وحدات الزمن المتاحة هي الميلي ثانية والثانية والدقيقة والساعة واليوم والأسبوع. |
العناقيد |
|
[vector: point] الافتراضي: |
حدّد الطبقة المتجهية لنتيجة التجميع العنقودي. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المعاملات المتقدمة
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
معاملة النقاط الحدّية كضوضاء (DBSCAN*) |
|
[boolean] الافتراضي: False |
إذا فُعّل هذا الخيار، تُعامَل النقاط الواقعة على حدود العنقود كنقاط غير مجمّعة، ولا توسَم كنقاط مجمّعة إلا النقاط الواقعة داخل العنقود. |
اسم حقل العنقود |
|
[string] الافتراضي: 'CLUSTER_ID' |
اسم الحقل الذي سيُخزَّن فيه رقم العنقود المرتبط |
اسم حقل حجم العنقود |
|
[string] الافتراضي: 'CLUSTER_SIZE' |
اسم الحقل الذي يحتوي على عدد المعالم في العنقود نفسه |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
العناقيد |
|
[vector: point] |
طبقة متجهية تحتوي على المعالم الأصلية مع حقل يحدد العنقود الذي تنتمي إليه |
عدد العناقيد |
|
[numeric: integer] |
عدد العناقيد المكتشفة |
شيفرة Python
معرّف الخوارزمية: native:stdbscanclustering
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.16. الإحصاءات حسب الفئات
تحسب إحصاءات حقل بناءً على فئة أصلية. والفئة الأصلية هي تركيبة من قيم حقول أخرى.
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الطبقة المتجهية المُدخلة |
|
[vector: any] |
طبقة متجهية مُدخلة تحتوي على فئات وقيم فريدة |
الحقل المراد حساب الإحصاءات عليه (إذا كان فارغًا يُحسب العدد فقط) اختياري |
|
[tablefield: any] |
إذا كان فارغًا فسيُحسب العدد فقط |
الحقل (أو الحقول) التي تحتوي على الفئات |
|
[tablefield: any] [list] |
الحقول التي تحدد الفئات (مجتمعةً) |
الإحصاءات حسب الفئة |
|
[vector: table] الافتراضي: |
حدّد جدول المخرجات للإحصاءات المولّدة. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الإحصاءات حسب الفئة |
|
[vector: table] |
جدول يحتوي على الإحصاءات |
بحسب نوع الحقل الذي يجري تحليله، تُعاد الإحصاءات التالية لكل قيمة مجمّعة:
الإحصاء |
خيط |
Numeric |
تاريخ |
|---|---|---|---|
العدد ( |
|
|
|
القيم الفريدة ( |
|
|
|
القيم الفارغة (null) ( |
|
|
|
القيم غير الفارغة ( |
|
|
|
القيمة الدنيا ( |
|
|
|
القيمة العظمى ( |
|
|
|
المدى ( |
|
||
المجموع ( |
|
||
القيمة المتوسطة ( |
|
||
القيمة الوسيطة ( |
|
||
الانحراف المعياري ( |
|
||
معامل الاختلاف ( |
|
||
الأقلية (القيمة الأندر تكرارًا - |
|
||
الأغلبية (القيمة الأكثر تكرارًا - |
|
||
الربيع الأول ( |
|
||
الربيع الثالث ( |
|
||
المدى الربيعي ( |
|
||
أدنى طول ( |
|
||
متوسط الطول ( |
|
||
أقصى طول ( |
|
شيفرة Python
معرّف الخوارزمية: qgis:statisticsbycategories
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.
24.1.22.17. مجموع أطوال الخطوط
تأخذ طبقة مضلعات وطبقة خطوط وتقيس إجمالي طول الخطوط وعددها الكلي التي تعبر كل مضلع.
تحتوي الطبقة الناتجة على المعالم نفسها للطبقة المضلعة المُدخلة، لكن مع سمتين إضافيتين تحتويان على طول الخطوط وعددها عبر كل مضلع.
ملاحظة
تستخدم هذه الخوارزمية قياسات مبنية على الإهليلج وتحترم إعدادات الإهليلج الحالية.
تتيح تعديل المعالم في مكانها لمعالم المضلعات
القائمة الافتراضية:
المعاملات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
الخطوط |
|
[vector: line] |
الطبقة المتجهية الخطية المُدخلة |
المضلعات |
|
[vector: polygon] |
طبقة متجهية مضلعة |
اسم حقل طول الخطوط |
|
[string] الافتراضي: 'LENGTH' |
اسم حقل طول الخطوط |
اسم حقل عدد الخطوط |
|
[string] الافتراضي: 'COUNT' |
اسم حقل عدد الخطوط |
طول الخط |
|
[vector: polygon] الافتراضي: |
حدّد الطبقة المضلعة الناتجة مع الإحصاءات المولّدة. أحد الخيارات التالية:
يمكن أيضًا تغيير ترميز الملف هنا. |
المخرجات
Label |
اﻷسم |
النوع |
وصف |
|---|---|---|---|
طول الخط |
|
[vector: polygon] |
طبقة مضلعات ناتجة تحتوي على حقلي طول الخطوط وعددها |
شيفرة Python
معرّف الخوارزمية: native:sumlinelengths
import processing
processing.run("algorithm_id", {parameter_dictionary})
يظهر معرّف الخوارزمية عند تمرير المؤشر فوق الخوارزمية في صندوق أدوات المعالجة. ويوفّر قاموس المعاملات أسماء المعاملات (NAME) وقيمها. انظر استخدام خوارزميات المعالجة من وحدة التحكم لمعرفة تفاصيل تشغيل خوارزميات المعالجة من وحدة تحكم Python.