22. المزيد من الربط المكاني
رأينا في القسم الأخير الدالتين ST_PointOnSurface(geometry) و ST_Union([geometry]) وبعض الأمثلة البسيطة. وفي هذا القسم سننفّذ بهما أمورًا أكثر تفصيلًا.
22.1. إنشاء جدول للمناطق الإحصائية (Census Tracts)
يوجد في المجلد \data\ الخاص بورشة العمل ملف يتضمن بيانات وصفية دون أشكال هندسية، هو nyc_census_sociodata.sql. يتضمن الجدول بيانات اجتماعية واقتصادية مثيرة للاهتمام عن New York: أزمنة التنقل إلى العمل، والدخل، والتحصيل التعليمي. لكن هناك مشكلة واحدة: البيانات ملخّصة حسب "المنطقة الإحصائية" (census tract)، وليس لدينا بيانات مكانية للمناطق الإحصائية!
في هذا القسم سنقوم بما يلي:
تحميل الجدول
nyc_census_sociodata.sqlإنشاء جدول مكاني للمناطق الإحصائية
ربط البيانات الوصفية بالبيانات المكانية
إجراء بعض التحليلات باستخدام بياناتنا الجديدة
22.1.1. تحميل nyc_census_sociodata.sql
افتح نافذة استعلام SQL في PgAdmin
اختر File->Open من القائمة وانتقل إلى الملف
nyc_census_sociodata.sqlاضغط زر "Run Query"
إذا ضغطت زر "Refresh" في PgAdmin، فيجب أن تتضمن قائمة الجداول الآن الجدول
nyc_census_sociodata
22.1.2. إنشاء جدول للمناطق الإحصائية (Census Tracts)
كما رأينا في القسم السابق، يمكننا بناء أشكال هندسية ذات مستوى أعلى من كتل التعداد عبر التلخيص على أجزاء فرعية من المفتاح blkid. وللحصول على المناطق الإحصائية، نحتاج إلى التلخيص مع التجميع حسب أول 11 حرفًا من blkid.
360610001001001 = 36 061 000100 1 001

36     = State of New York
061    = New York County (Manhattan)
000100 = Census Tract
1      = Census Block Group
001    = Census Block
أنشئ الجدول الجديد باستخدام الدالة التجميعية ST_Union:
-- Make the tracts table
CREATE TABLE nyc_census_tract_geoms AS
SELECT
  ST_Union(geom) AS geom,
  SubStr(blkid,1,11) AS tractid
FROM nyc_census_blocks
GROUP BY tractid;

-- Index the tractid
CREATE INDEX nyc_census_tract_geoms_tractid_idx
  ON nyc_census_tract_geoms (tractid);
22.1.3. ربط البيانات الوصفية بالبيانات المكانية
اربط جدول الأشكال الهندسية للمناطق الإحصائية بجدول بياناتها الوصفية عبر ربط وصفي قياسي
-- Make the tracts table
CREATE TABLE nyc_census_tracts AS
SELECT
  g.geom,
  a.*
FROM nyc_census_tract_geoms g
JOIN nyc_census_sociodata a
ON g.tractid = a.tractid;

-- Index the geometries
CREATE INDEX nyc_census_tract_gidx
  ON nyc_census_tracts USING GIST (geom);
22.1.4. الإجابة عن سؤال مثير للاهتمام
أجب عن سؤال مثير للاهتمام! "اسرد أعلى 10 أحياء في New York مرتّبة حسب نسبة الحاصلين على شهادات دراسات عليا."
SELECT
  100.0 * Sum(t.edu_graduate_dipl) / Sum(t.edu_total) AS graduate_pct,
  n.name, n.boroname
FROM nyc_neighborhoods n
JOIN nyc_census_tracts t
ON ST_Intersects(n.geom, t.geom)
WHERE t.edu_total > 0
GROUP BY n.name, n.boroname
ORDER BY graduate_pct DESC
LIMIT 10;
نجمع الإحصاءات التي تهمّنا، ثم نقسم بعضها على بعض في النهاية. ولتجنّب أخطاء القسمة على صفر، لا نُدخل المناطق الإحصائية التي يبلغ عدد سكانها صفرًا.
 graduate_pct |       name        | boroname
--------------+-------------------+-----------
         47.6 | Carnegie Hill     | Manhattan
         42.2 | Upper West Side   | Manhattan
         41.1 | Battery Park      | Manhattan
         39.6 | Flatbush          | Brooklyn
         39.3 | Tribeca           | Manhattan
         39.2 | North Sutton Area | Manhattan
         38.7 | Greenwich Village | Manhattan
         38.6 | Upper East Side   | Manhattan
         37.9 | Murray Hill       | Manhattan
         37.4 | Central Park      | Manhattan
ملاحظة
سيتساءل الجغرافيون في New York عن وجود "Flatbush" في قائمة الأحياء ذات التعليم العالي هذه. نناقش الإجابة في القسم التالي.
22.2. الربط بين المضلعات
في استعلامنا المثير للاهتمام (في الإجابة عن سؤال مثير للاهتمام) استخدمنا الدالة ST_Intersects(geometry_a, geometry_b) لتحديد مضلعات المناطق الإحصائية التي ستُدرج في ملخّص كل حي. وهذا يقودنا إلى السؤال: ماذا لو وقعت منطقة إحصائية على الحدود بين حيّين؟ ستتقاطع مع كليهما، وبالتالي ستُدرج في الإحصاءات الملخّصة لـ كليهما.
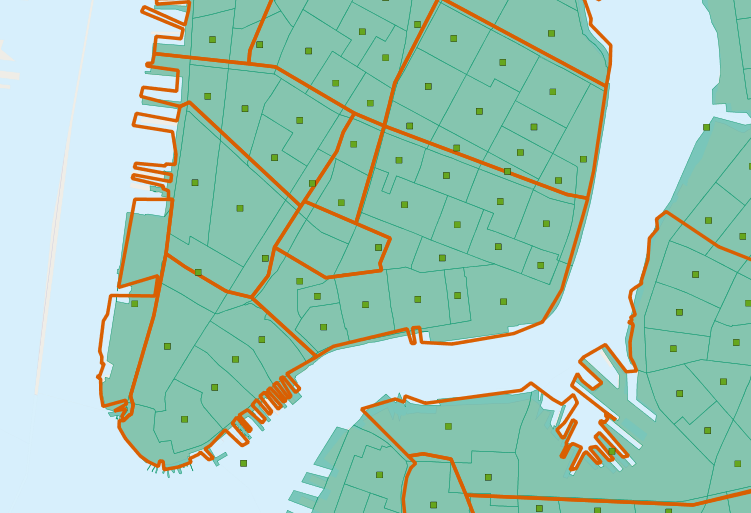
لتجنّب هذا النوع من العدّ المزدوج، هناك طريقتان:
الطريقة البسيطة هي ضمان وقوع كل منطقة إحصائية في منطقة تلخيص واحدة فقط (باستخدام ST_PointOnSurface(geometry))
الطريقة المعقّدة هي تقسيم المناطق الإحصائية العابرة عند الحدود (باستخدام ST_Intersection(geometry,geometry))
إليك مثالًا على استخدام الطريقة البسيطة لتجنّب العدّ المزدوج في استعلامنا عن التعليم العالي:
SELECT
  100.0 * Sum(t.edu_graduate_dipl) / Sum(t.edu_total) AS graduate_pct,
  n.name, n.boroname
FROM nyc_neighborhoods n
JOIN nyc_census_tracts t
ON ST_Contains(n.geom, ST_PointOnSurface(t.geom))
WHERE t.edu_total > 0
GROUP BY n.name, n.boroname
ORDER BY graduate_pct DESC
LIMIT 10;
لاحظ أن تنفيذ الاستعلام يستغرق الآن وقتًا أطول، لأن الدالة ST_PointOnSurface يجب تشغيلها على كل منطقة إحصائية.
 graduate_pct |        name         | boroname
--------------+---------------------+-----------
         48.0 | Carnegie Hill       | Manhattan
         44.2 | Morningside Heights | Manhattan
         42.1 | Greenwich Village   | Manhattan
         42.0 | Upper West Side     | Manhattan
         41.4 | Tribeca             | Manhattan
         40.7 | Battery Park        | Manhattan
         39.5 | Upper East Side     | Manhattan
         39.3 | North Sutton Area   | Manhattan
         37.4 | Cobble Hill         | Brooklyn
         37.4 | Murray Hill         | Manhattan
تجنّب العدّ المزدوج يغيّر النتائج!
22.2.1. ماذا عن Flatbush؟
على وجه الخصوص، خرج حي Flatbush من القائمة. ويمكن معرفة السبب بالنظر عن كثب إلى خريطة حي Flatbush في جدولنا.
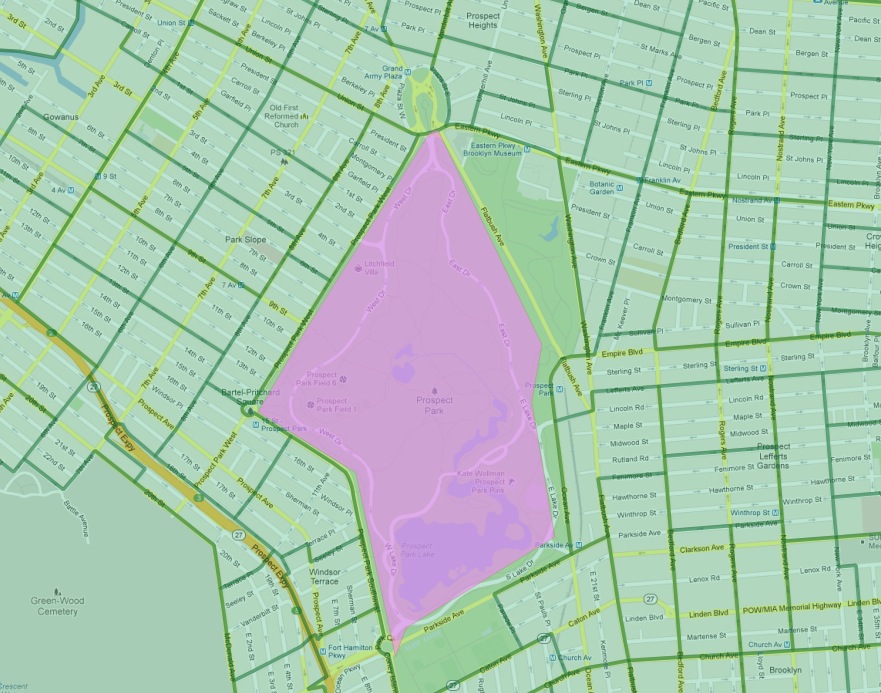
وفقًا لتعريف مصدر بياناتنا، فإن Flatbush ليس حيًا بالمعنى التقليدي، إذ يغطي مساحة Prospect Park فقط. ومن الطبيعي أن تسجّل المنطقة الإحصائية لتلك المساحة صفرًا من السكان. لكن حدود الحي تلامس إحدى المناطق الإحصائية الغالية المحاذية للجانب الشمالي من المنتزه (في حي Park Slope الذي شهد تحسينًا عمرانيًا). وعند استخدام اختبارات المضلع/المضلع، أُضيفت هذه المنطقة الإحصائية الوحيدة إلى Flatbush الخالي من السكان لولاها، ما أدى إلى الدرجة المرتفعة جدًا في ذلك الاستعلام.
22.3. الربط بالمسافة ضمن نصف قطر كبير
من الاستعلامات الممتعة أن نسأل: "كيف تختلف أزمنة التنقل لدى الأشخاص القريبين من محطات المترو (ضمن 500 متر) عنها لدى البعيدين عنها؟"
لكن هذا السؤال يصطدم ببعض مشكلات العدّ المزدوج: فكثير من الأشخاص سيكونون ضمن 500 متر من عدة محطات مترو. قارن عدد سكان New York:
SELECT Sum(popn_total)
FROM nyc_census_blocks;
8175032
بعدد سكان New York الواقعين ضمن 500 متر من محطة مترو:
SELECT Sum(popn_total)
FROM nyc_census_blocks census
JOIN nyc_subway_stations subway
ON ST_DWithin(census.geom, subway.geom, 500);
10855873
عدد الأشخاص القريبين من المترو أكبر من عدد السكان كلهم! من الواضح أن استعلام SQL البسيط يرتكب خطأ عدّ مزدوج كبيرًا. ويمكنك رؤية المشكلة بالنظر إلى صورة النطاقات العازلة حول المترو.
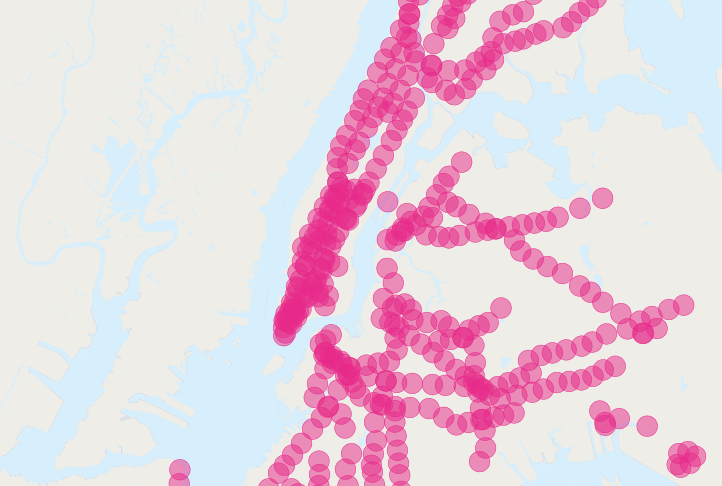
الحل هو ضمان أن تكون لدينا كتل تعداد مميّزة (غير مكررة) فقط قبل تمريرها إلى جزء التلخيص في الاستعلام. ويمكننا ذلك بتقسيم استعلامنا إلى استعلام فرعي يعثر على الكتل المميّزة، يُغلّفه استعلام تلخيصي يعيد إجابتنا:
WITH distinct_blocks AS (
  SELECT DISTINCT ON (blkid) popn_total
  FROM nyc_census_blocks census
  JOIN nyc_subway_stations subway
  ON ST_DWithin(census.geom, subway.geom, 500)
)
SELECT Sum(popn_total)
FROM distinct_blocks;
5005743
هذا أفضل! إذن ما يزيد قليلًا على نصف سكان New York يقعون ضمن 500m (نحو 5-7 دقائق سيرًا على الأقدام) من المترو.